


Gut lesen oder gar nicht antworten: Das Dilemma bei Vergabeunterlagen
Öffentliche Ausschreibungen sind ein Sonderfall für Sprachmodelle. Die entscheidenden Informationen stehen nicht in der Bekanntmachung, sondern in den Vergabeunterlagen: Leistungsverzeichnis, Eignungskriterien, Ausschlusskriterien, Bewertungsmatrix, verteilt über Anlagen mit oft mehreren hundert Seiten. Wer diese Dokumente nicht liest, qualifiziert nicht, sondern filtert.
Bidpoint.ai hat über hundertausende Vergabedokumente analysiert und dabei eine Erfahrung gemacht, die jedes Modell am Markt betrifft: Modelle, die lange Dokumente zuverlässig lesen, sind langsam und teuer. Modelle, die schnell und günstig sind, übersehen Kriterien. Bei über 325.000 aktiven Ausschreibungen in Deutschland ist das kein technisches Detail, sondern die Frage, ob eine Qualifizierung in der Masse überhaupt möglich ist.
Atlas ist unsere Antwort darauf. Und weil wir Benchmarks für aussagekräftiger halten als Adjektive, veröffentlichen wir sie. Nach unserer Kenntnis tut das kein anderer Anbieter im deutschen Vergabemarkt.
Atlas 1.2 in vier Zahlen
Atlas 1.1 zu Atlas 1.2: Was sich verbessert hat
Atlas 1.2 ist ein neues Modell, kein Update der Bewertungsregeln. Es rechnet pro erzeugtem Token rund fünfmal so viel wie Atlas 1.1. Auf öffentlichen Standard-Benchmarks, für beide Versionen unter identischen Bedingungen unabhängig gemessen, sieht der Sprung so aus:
Drei dieser Werte entscheiden über die Qualität einer Qualifizierung.
Lange Vergabeunterlagen. Die Eignungskriterien stehen selten auf Seite 1. Häufig liegen sie in Anlage 7 auf Seite 180, formuliert als Verweis auf eine Norm und eine Mindestreferenz. Long-Context Reasoning misst genau das: Findet und verknüpft das Modell Informationen, die weit auseinander in einem langen Text liegen? Atlas 1.1 lag bei 52 Prozent, Atlas 1.2 bei 82 Prozent. In der Praxis heißt das: weniger übersehene Ausschlusskriterien und weniger Ausschreibungen, die im Score gut aussehen und beim Lesen durchfallen.
Weniger geratene Antworten. Der Omniscience-Index belohnt richtige Antworten und bestraft falsche stärker als ein ehrliches "unbekannt". Ein Wert von 0 bedeutet, dass ein Modell genauso oft richtig liegt wie es falsch rät. Atlas 1.1 lag bei −49, Atlas 1.2 bei −10. Ein erfundenes Eignungskriterium kostet mehr als ein fehlendes, weil es eine passende Ausschreibung aus Ihrer Pipeline wirft. Atlas 1.2 schreibt in solchen Fällen "in den Unterlagen nicht enthalten", statt eine Angabe zu erfinden.
Gleiche Steuerbarkeit. Die Anweisungstreue hat sich kaum bewegt. Das ist gewollt. Atlas 1.2 hält sich an dieselben Bewertungsregeln und dasselbe Ausgabeformat wie Atlas 1.1. Ihre Scores bleiben auf derselben Skala, Ihre Filter und Benachrichtigungen funktionieren unverändert.
Atlas 1.2 im Vergleich zum Markt
Die interessantere Frage ist nicht, ob Atlas 1.2 besser ist als Atlas 1.1, sondern wie es gegen die Modelle abschneidet, die man alternativ für die Qualifizierung einsetzen könnte. Wir haben die drei Größen nebeneinandergelegt, die dafür zählen: Wie gut liest ein Modell lange Dokumente, wie schnell erzeugt es seine Bewertung, und wie lange dauert es bis zur ersten Antwort.
Alle Fremdwerte sind unabhängige Messungen auf der jeweils höchsten Reasoning-Stufe, Stand September 2026.
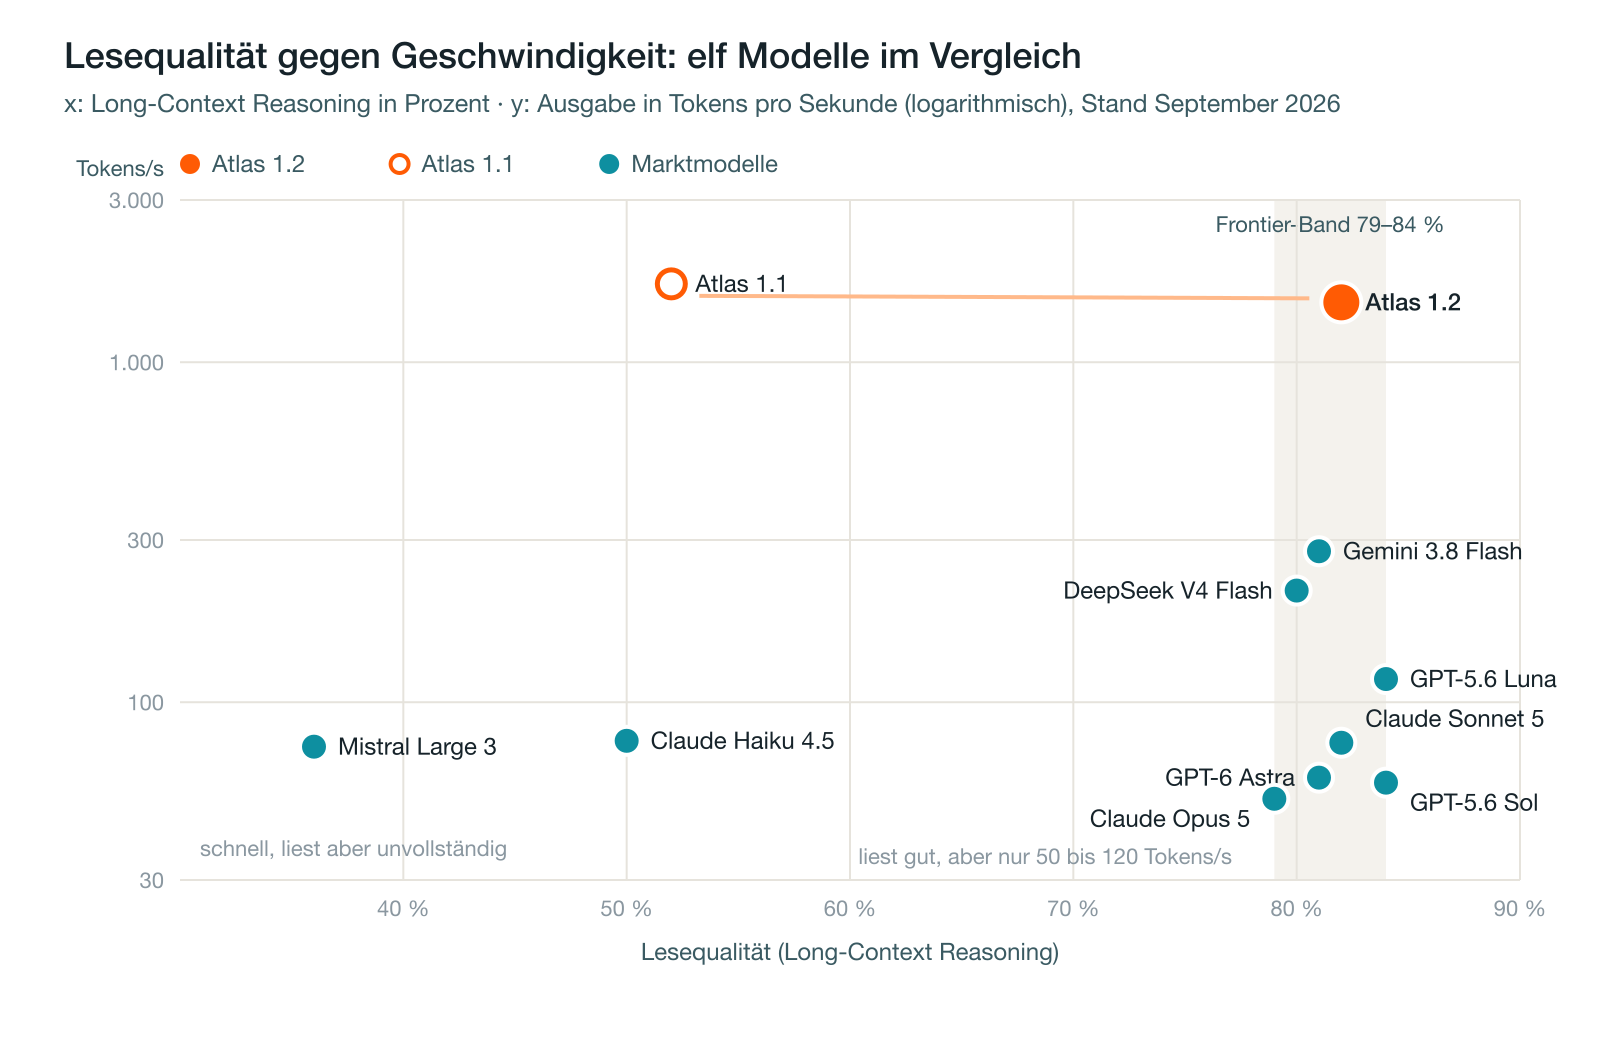
Die Tabelle zeigt das Muster, das den Markt bestimmt. Die Modelle in der oberen Hälfte lesen lange Dokumente gut, liefern aber 50 bis 120 Tokens pro Sekunde und brauchen bis zur ersten Antwort zwischen einer und fünf Minuten. Die Modelle in der unteren Hälfte antworten schnell, verlieren aber beim Lesen ein Drittel bis die Hälfte der Informationen. Gemini 3.8 Flash und DeepSeek V4 Flash sind die einzigen, die beides annähernd verbinden, und liegen bei der Ausgabe trotzdem um den Faktor 5 bis 7 hinter Atlas 1.2.
Kein Modell am Markt kombiniert Lesequalität auf Frontier-Niveau mit 1.500 Tokens pro Sekunde. Das ist der Unterschied, für den wir Atlas betreiben.
Was 1.500 Tokens pro Sekunde in der Praxis bedeuten
Eine Qualifizierung braucht rund 2.000 Tokens Denk- und Ausgabearbeit: Lesen der Unterlagen gegen das Firmenprofil, Score, Begründung, gefundene Kriterien mit Fundstelle. Rechnet man das auf ein Firmenprofil hoch, das gegen 10.000 Ausschreibungen neu bewertet wird, ergibt sich auf einem einzigen Verarbeitungsstrang:
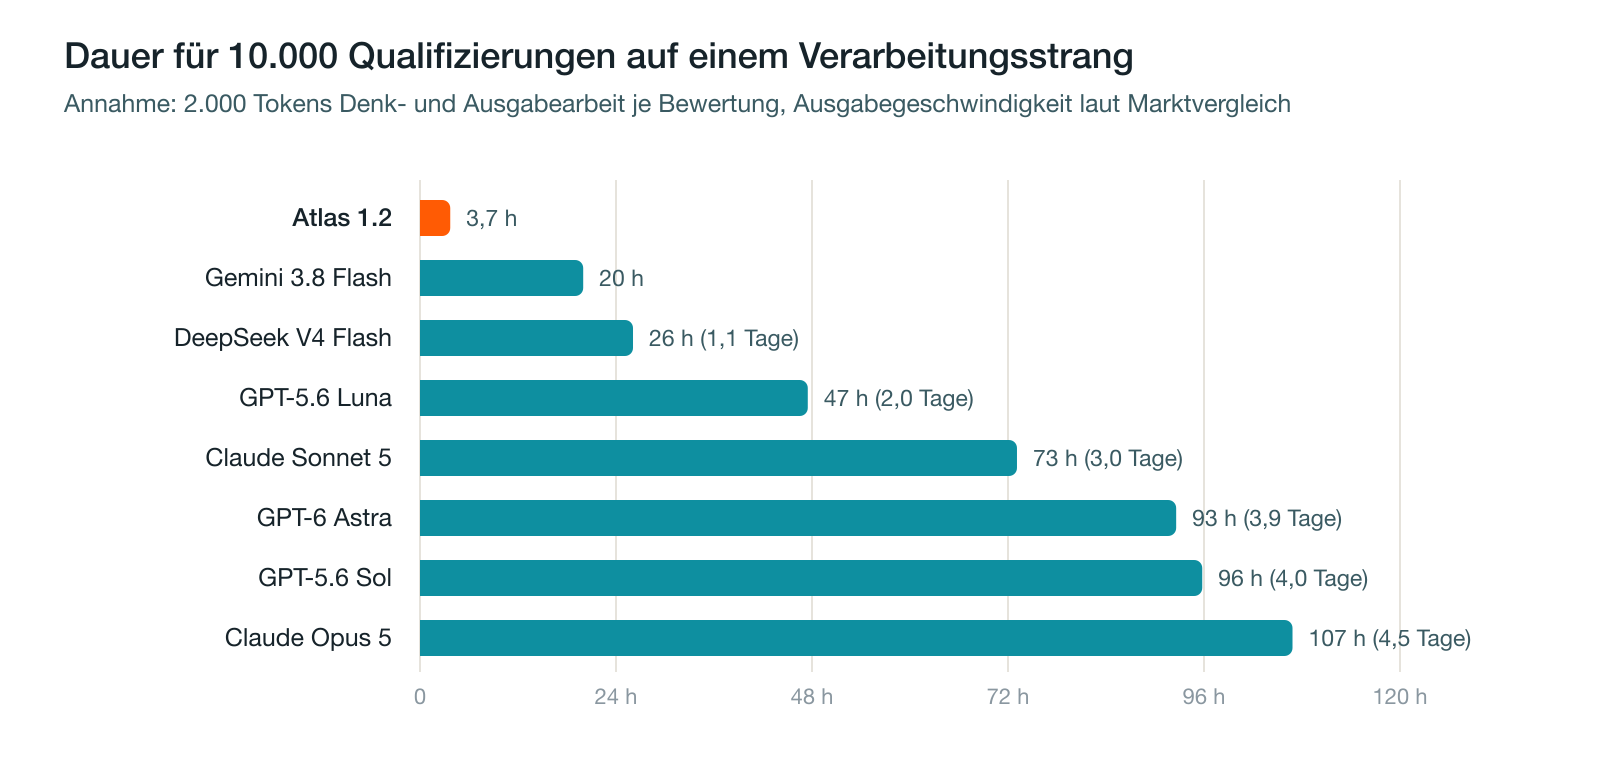
Zur Geschwindigkeit kommt der Preis. Zu Listenpreisen kostet dieselbe Neubewertung bei den großen Modellen zwischen 280 und 1.400 US-Dollar, je Profil und je Durchlauf. Für einen Kunden mit fünf Firmenprofilen und wöchentlicher Neubewertung wären das mit GPT-6 Astra über 350.000 US-Dollar im Jahr.
Annahme je Bewertung: 4.000 Tokens Eingabe (Unterlagen und Firmenprofil), 2.000 Tokens Denk- und Ausgabearbeit. Listenpreise Stand September 2026.
Für Sie hat das zwei konkrete Folgen. Erstens: Wenn Sie Ihr Firmenprofil ändern, etwa eine neue Kernleistung ergänzen oder eine Region ausschließen, ist Ihre Pipeline innerhalb von Stunden neu sortiert, nicht Ende der Woche. Zweitens: Neue Ausschreibungen aus knapp 90 Portalen sind bewertet, bevor Ihr Arbeitstag beginnt.
Was das für Ihre Arbeit bedeutet
Sie müssen nichts umstellen. Atlas 1.2 ist seit heute für alle Kunden aktiv. Drei Dinge werden Sie bemerken:
- Scores verschieben sich leicht. Einzelne Ausschreibungen, die bisher bei 70 lagen, stehen jetzt bei 55, weil Atlas 1.2 ein Ausschlusskriterium in einer Anlage gefunden hat. Das ist beabsichtigt.
- Begründungen werden konkreter. Statt "Referenzen gefordert" steht dort "drei vergleichbare Referenzen der letzten fünf Jahre, Anlage 4, Abschnitt 2.3".
- Weniger falsche Ausschlüsse. Wenn eine Angabe in den Unterlagen fehlt, sagt Atlas 1.2 das und wertet die Ausschreibung nicht ab.
Wo Atlas 1.2 nicht vorn liegt
Ein Benchmark-Vergleich, der nur die gewonnenen Zeilen zeigt, ist Werbung. Deshalb auch die anderen: Bei Weltwissen und Fachfragen über alle Disziplinen (Humanity's Last Exam) liegt GPT-6 Astra mit 55 Prozent vor Atlas 1.2 mit 34 Prozent. Beim Omniscience-Index erreichen Astra und Claude Opus 5 positive Werte, Atlas 1.2 liegt bei −10. Bei Physik-Aufgaben und agentischer Software-Entwicklung ist der Abstand noch größer.
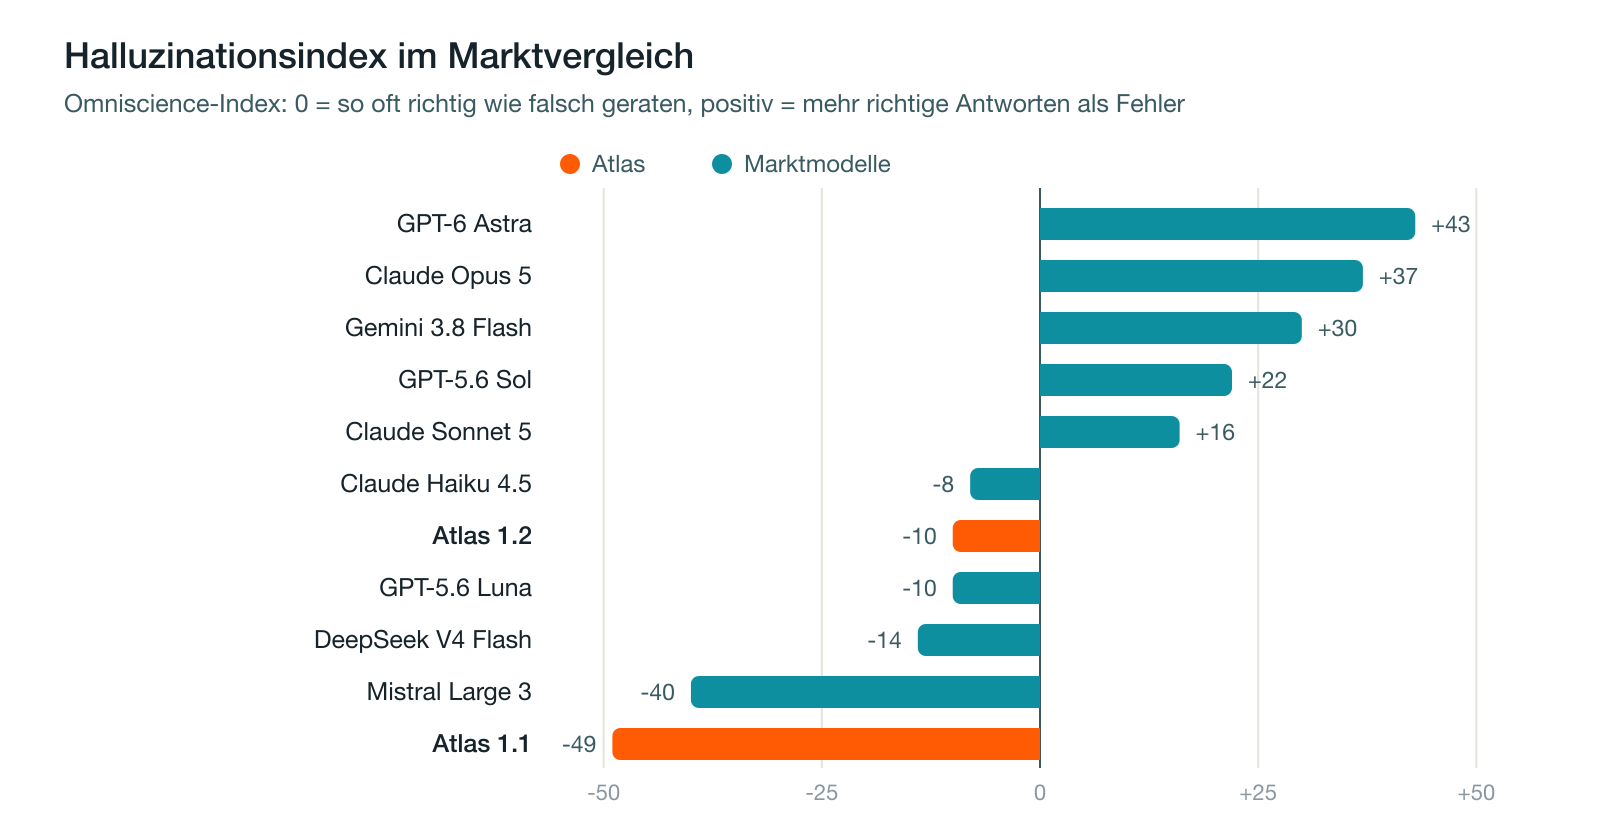
Für die Qualifizierung von Ausschreibungen spielt das keine Rolle. Atlas soll nicht wissen, was in der Welt ist, sondern was in den Unterlagen steht. Dort, beim Lesen langer Dokumente, liegt es gleichauf mit den größten Modellen. Ob eine Ausschreibung zu Ihrem Unternehmen passt, entscheidet weiterhin Ihr Team. Atlas bereitet die Go/No-Go-Entscheidung vor, es trifft sie nicht.
Fazit
Atlas 1.2 verbessert die zwei Eigenschaften, die bei der Qualifizierung von Ausschreibungen zählen: Es liest lange Vergabeunterlagen so zuverlässig wie GPT-6 Astra und Claude Sonnet 5 (82 Prozent im Long-Context-Benchmark) und rät deutlich seltener als sein Vorgänger (Omniscience-Index von −49 auf −10). Dabei antwortet es mit rund 1.500 Tokens pro Sekunde, 25-mal schneller als GPT-6 Astra und 5-mal schneller als das schnellste Frontier-Modell am Markt.
Wenn Sie sehen möchten, wie Atlas 1.2 Ihre Ausschreibungen bewertet, vereinbaren Sie eine Demo. Sie bringen Ihr Firmenprofil mit, wir zeigen Ihnen die Qualifizierung an echten Vergaben aus Ihrem Segment.


